




















ChatGPTの「ウソ」を暴くツールが登場
ChatGPTはユーザーのどのような問いかけに対しても自然で流ちょうな文章を返してくる。だが、課題もある。内容に「ウソ」が含まれている場合があるのだ。これを解消するのに役立つツールが開発された。
「ChatGPT」とやりとりしていると、返ってきた回答が事実かどうかが分からず、困ったことはないだろうか。ChatGPTが返した回答の真実性を効率的に確認できる方法があるようだ。
どうやって「ChatGPT」のウソを暴くのか?
上海交通大学やカーネギーメロン大学、香港城市大学、ニューヨーク大学、Meta AI、香港科技大学、上海人工知能実験室に所属する研究者グループは、「ChatGPT」などの大規模言語モデル(LLM)が生成する文書のファクトチェックをするツール「FacTool」を開発し、2023年7月25日に論文を公開した。OpenAIのAPIキーがあれば、FacToolをダウンロードして試すこともできる。
FacToolは次の4つのタスクを実行できる。
(1)知識ベースのQ&A 事実誤認を検出
(2)コード生成 コード生成における実行エラーを検出
(3)数学的推論 計算エラーを検出
(4)科学的文献レビュー 存在しない科学文献を検出
FacToolは怪しい要素を抽出する他、クエリの生成やツールクエリ、証拠収集、合意検証の5つの主要コンポーネントから成る。
下図にあるように、まずChatGPTなどが生成したコンテンツから怪しい要素を複数抽出する(1)。続いて、要素をクエリのリストに変換する(2)。これらのクエリをGoogle検索や「Google Scholar」「Code Interpreter」などに渡し(3)、関連する情報を収集する(4)。最後に、集めた情報を用いて各要素が事実かどうかを評価する(5)。
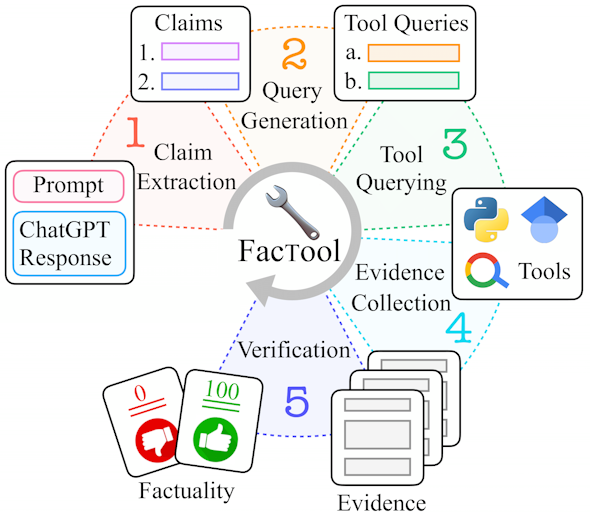 FacToolの動作フロー(出典:https://github.com/GAIR-NLP/factool)
先ほどの4つのタスクについて、動作フローを実例で示したのが次の図だ。
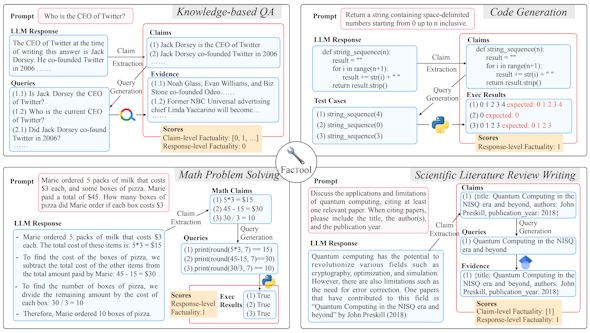 FacToolのフレームワーク(出典:https://arxiv.org/abs/2307.13528)
図の左上は知識ベースのQ&Aの例だ。Twitter(現「X」)のCEOが誰かと質問したところ、LLMは「この回答を書いている時点のツイッターのCEOはジャック・ドーシーだ。彼は2006年にツイッターを共同設立した」と回答した。この2つの主張を抽出し(1)、「ジャック・ドーシーはTwitterのCEOですか」「現在のTwitterのCEOは誰ですか」「ジャック・ドーシーは2006年にTwitterを共同設立しましたか」という3つのクエリを生成した(2)。これをGoogle検索にかけて(3、4)、主張レベルの事実性(Claim-level Factuality)と応答レベルの事実性(Response-level Factuality)の数値を算出する(5)。
主張レベルの事実性とは、生成AIが作り出した複数の回答が互いに矛盾せず、一貫性があるかどうかを確認するものだ。情報の整合性と事実性を評価する。
応答レベルの事実性とは、生成AIの回答が事実かどうかを評価する指標だ。回答が事実に基づいているかどうか、誤った情報を含んでいないかどうかを判定する。
自然な形でChatGPTと統合可能
FacToolはインストール可能な形でGitHubに公開されている。ユーザーが追加の情報を入力しなくてもFacToolは動作する。
次のデモではワールド・ベースボール・クラシックで日本が何回優勝したのかをChatGPTに問いかけた。ChatGPTが回答を表示した後にFacToolを呼び出すことで、誤った部分の訂正が可能になった。ChatGPTは2021年9月までの情報しか持っていないが、FacToolを介することで2023年の大谷翔平選手の活躍も回答できた。
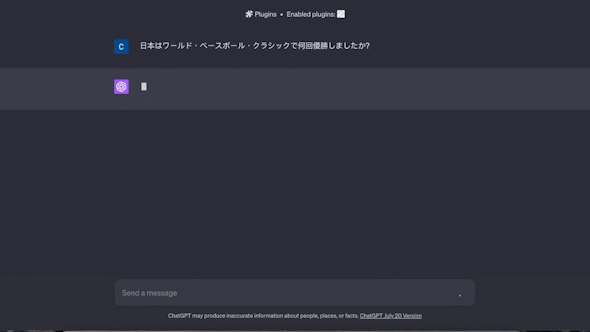 ChatGPTと同じ画面でファクトチェックができる。青がユーザー入力、紫色がChatGPTの出力(クリックで再生、出典:https://github.com/GAIR-NLP/factool)
回答の誤りは生成AIの種類によって違っている
研究チームはChatGPTなどの生成AIがどの程度正確な回答を返してくるのか、FacToolでベンチマークした。知識ベースのQ&Aとコード生成、数学の問題解決、科学論文のレビュー執筆の4つのタスクを評価した。
ベンチマークの対象は「生の」GPT-4、ChatGPT、Googleの「Bard」、Anthropicの「Claude-v1」、カリフォルニア大学バークレー校などの研究チームによる「Vicuna」だ。
GPT-4はChatGPTやBard、Claude-v1、Vicunaと比較して、最も回答同士の矛盾が少なく、事実に基づいていた。2番手はChatGPTだった。「Vicuna-13B」は知識ベースのQAでは良好な成績を残したものの、コード生成や数学の問題解決、科学論文のレビュー執筆など、より困難なシナリオでは性能が低かった。
この結論を2つの指標で示したのが次の表だ。重み付けされ主張レベルの正答率(WCLA:Weighted Claim-Level Accuracy)と、応答レベルの正答率(RLA:Response-Level Accuracy)についてベンチマークの結果をLLMの種類別に示した。
重み付けとは、複数の質問が異なる重要度を持つことがあるため、重要度に応じて評価を調整したことを意味する。いずれも数値が大きいほど正答率が高い。
| LLMの名称 | WCLA | RLA |
|---|---|---|
| GPT-4 | 75.60 | 43.33 |
| ChatGPT | 68.63 | 36.67 |
| Claude-v1 | 63.95 | 26.67 |
| Bard | 61.15 | 33.33 |
| Vicuna-13B | 50.35 | 21.67 |
生成AIの進歩はまだまだ続いている。「GPT-4」の後継版が登場するのはほぼ確実だ。次世代ChatGPTは、FacToolのような機能を内蔵するようになるかもしれない。そのような選択肢があることを期待する。
Copyright © ITmedia, Inc. All Rights Reserved.


ニュースピックアップ
この記事の著者

関連記事
こんなメディアも見られています
キーマンズネットに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
「Claude」3倍高速化の裏で、Anthropic開発者が「あえてしなかったこと」:899th Lap
-
2
山梨県が「自治体ごとに違う」をなくす 県と全27市町村で電子契約を共通化
-
3
Javaアプレットは、なぜ今も情シスを悩ませる? 残った業務システムの“延命”問題
-
4
AIエージェントでサイバー攻撃は100倍速に 2026年最新事例から見る防御策とは
-
5
マネーフォワード、2800人の情報をNotionに集約 「AIに聞けば分かる」環境へ
-
6
ロッテ、「経費の全件チェック」をやめて処理を50%削減 プロセスを担当者に聞いた
-
7
自治体、企業で進む「Google回帰」 事例で分かる「Gemini Notebook」の活用アイデア
-
8
CodexやClaude Codeが作ったアプリ、実は「未完成」かも 本当に「完成」させる“5つの条件”
-
9
PostgreSQLより1.81倍高速? 開発者がSQLの実行を小型AIに丸投げしてみた結果:898th Lap
-
10
6つの条件から見るCopilot、Claude、IBM Bob、組織に適した生成AIの選定ポイント
キーマンズネット SNS
 @Keymansをフォロー
インフォメーション
注目情報をチェック
キーマンズネットをフォロー