




















情報分析基盤を内製したLIXIL、デジタル変革の道のりは「名寄せ」から?(3/4 ページ)
どうする? 顧客情報の「クレンジング」「名寄せ」を考えてみた
船水氏らは名寄せ実施に当たって、顧客情報をどこまで生かせるかを検討している。重複や不明、不正なデータなどを除いた「きれいな顧客情報」がどのくらい得られるかの検証だ。
その結果、メールなどでリーチできる顧客が約101万世帯も存在することが明らかになった。同社の場合、名寄せは左図のようなフローで実施している。
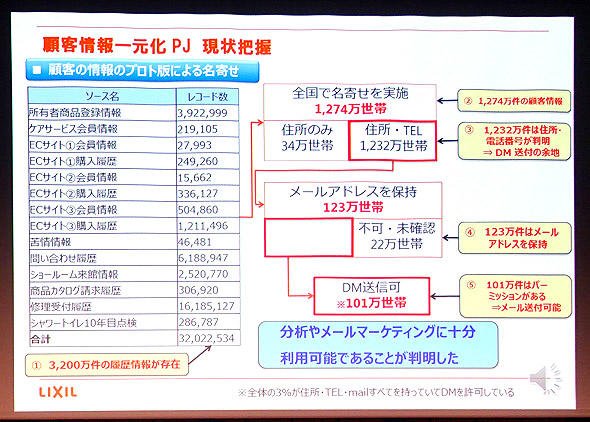 各システムが持つ顧客情報から、有効なデータを確認。併せて無効なデータに対する処理方法も決定した
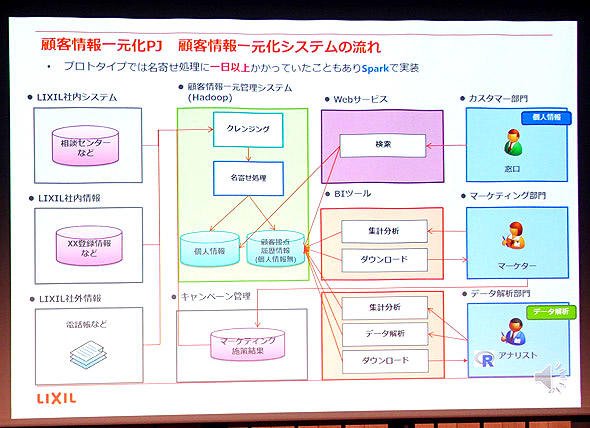 システム全体像
「名寄せ」の前に下準備として最も重い作業がデータクレンジングだ。システムが異なると、異字体の扱い、電話番号や郵便番号のハイフンや全角/半角などの数字の扱い、住所の分割位置の違いなど、運用ルールが大きく異なる。また、有効でないデータが入力されているケースでは適切にチェックして取り除く必要もある。こうしたことから、実際に名寄せを行う前に、格納データそのものを一定のルールの下で整えていく行程がデータクレンジングだ。
これらも実際の格納データの特性を分析し、登録データを無駄にしない方法を考えつつ、場合によっては潔く「きれいな無効データ」に変換するといった判断も必要になる。
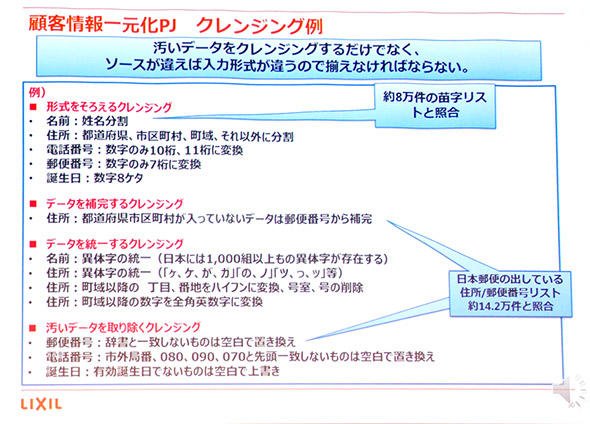
情報システム担当である船水氏は、自らクレンジングの方法を検討。公的な辞書情報と照合しながら、必要に応じて各レコードを一定のルールで修正、補完する方法を採用した。併せて無効なデータを取り除く処理も行っている。これだけの件数に複雑な処理を加えるため、処理の手法は事前に小さめのデータで幾つかの方法を評価している。
ここで単純なプログラムによる文字列操作と比較して、インメモリデータ分析が可能なApache Sparkを使った場合、約260倍も高速に処理ができたという。
「インメモリ処理ができるApache Sparkはデータ量の多いリストとのマッチングに適している、との知見が得られた」(船水氏)
住所のクレンジングでも同様の比較をしている。住所の場合、(1)郵便番号辞書を使った補完、(2)住所の適切な分割、(3)番地などの表記の統一、(4)住所に含まれる異自体の統一と、4つの処理を同時に実行する必要がある。処理をイメージした方には想像が付くと思うがこちらもやはり、メモリをうまく利用できるApache Sparkが得意とする領域。こちらは処理が複雑だったこともあり、Pythonプログラムによる操作と比較すると878倍も高速だったとしている。
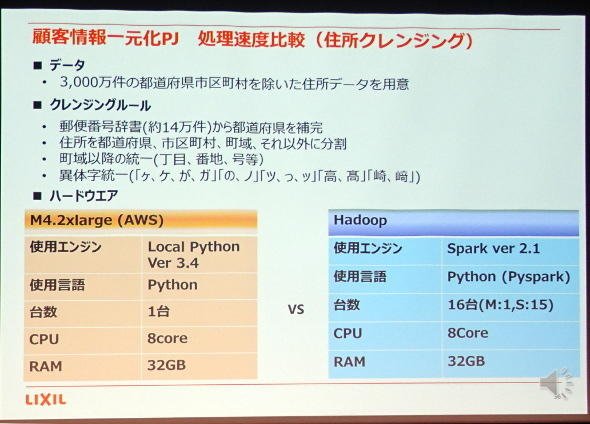 住所クレンジング方法の検討
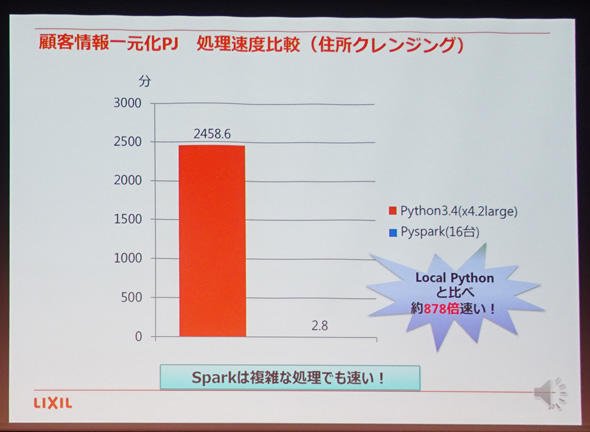 検証結果
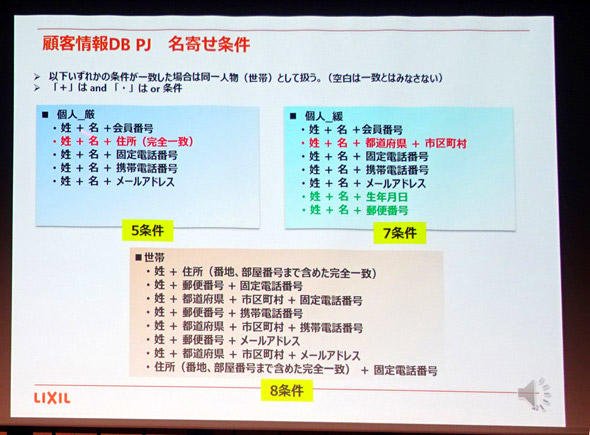
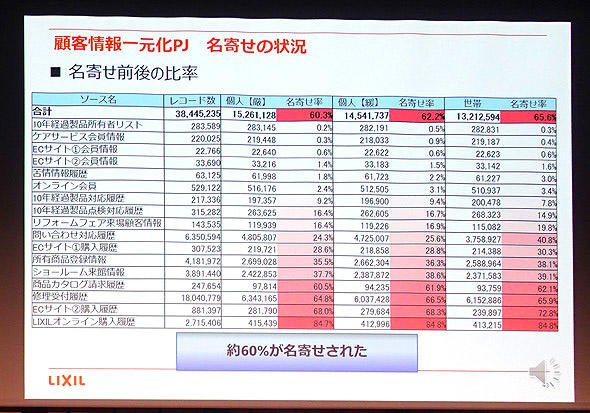
こうした検証を経て、実際の顧客情報DBの「名寄せの条件」と実施環境を決定、実際の運用では、全体の約60%が名寄せできている状況だ。
Copyright © ITmedia, Inc. All Rights Reserved.


事例で学ぶ! 業務改善のヒント
この記事の著者

こんなメディアも見られています
キーマンズネットに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
C言語は「危険」と言われても、専門家が「使う価値は十分にある」と言うワケ:900th Lap
-
2
M365 Copilot全庁展開で月2000時間削減 現場がAIを「使いたくなる」習慣化の仕組み
-
3
かんぽ生命が営業報告を50分→10分に AI時代に見直すべき「データ入力」の仕組み
-
4
損保ジャパン、2万人の「Gemini活用」どう管理? 推進者が語る「リスク回避」の仕組み
-
5
Claude Codeに「仕事を丸投げ」して事故らないための基本運用ルール
-
6
6TBファイルのサーバ移行、M365ユーザーの八雲町がSharePointでなく「あえてBox」の理由
-
7
「カスハラ対応」を個人に任せない 取手市がAIで変えた窓口業務
-
8
「Claude」3倍高速化の裏で、Anthropic開発者が「あえてしなかったこと」:899th Lap
-
9
3億人分の情報漏えい事件から見えた、金銭では済まない代償とは
-
10
20年物の基幹システム刷新に、マクロミルがあえて「全てを変えない」と決めた理由
キーマンズネット SNS
 @Keymansをフォロー
インフォメーション
注目情報をチェック
キーマンズネットをフォロー