




















すご腕アナリスト市場予測
大衆化とは違う “AIの民主化”の本質(2/3 ページ)
日本におけるAIの民主化を阻む3つの論点
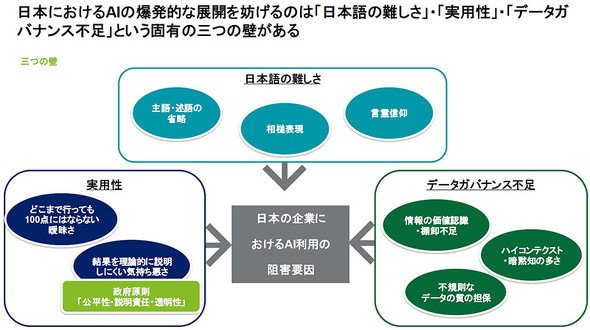
意識する、しないにかかわらず、AI技術を日常的に利用可能な環境が整備されている今、グローバルはもちろん、日本においてもAIの利用は大きく進んでいくことが考えられる。しかし、日本にいてAIの民主化を成し遂げていくためには、いくつかの課題をクリアしていく必要があると考えている。主なものとしては、「日本語」「実用性」「データガバナンス」という3つの論点だ。
英語がベースで進むAIをローカライズ「日本語」
多くのIT製品にいえることではあるが、もともと英語圏で開発されたテクノロジーを日本で利用する場合は、その国の言語に翻訳するローカライズが必要になるケースが多い。AIの場合は、単にインタフェースを日本語化するというよりも、より深い語学としての対応が求められる。特に、文法や意味に揺らぎのある日本語という言語をAIに学習させていくのは難しい。例えば文章内で主語や述語が省略される際には、単語だけを切り出して分割しても主語や述語が特定できないなど、英語圏で育まれた認知系の技術で対応することが困難なことも少なくない。“大丈夫”という相づちの表現も、文脈によっては肯定とも否定ともとれるのが日本語であり、これらを含めてAIに理解、学習させていくのは大変な労力が伴うことだろう。事実、グローバル企業が提供するクラウドサービスにて提供されているAIでも日本語はもちろん利用可能だが、精度の高さが求められるビジネス領域では、まだ十分に機能しているとは言い難い。
また中途半端な日本語がアウトプットされることで、UX(User Experience)やCX(Customer Experience)などの体験が損なわれてしまう可能性も否定できない。ある程度違和感のない日本語での体験価値を提供することが、AIが実際に活用できるものと認知されることにつながってくるはずだ。
公平性を担保しながら透明性を高めることが必要な「実用性」
AIの主流である認知系の技術は、確率と統計に基づくアプローチとなっており、与えられたインプットの情報を過去得られたデータと比較しながら類推し、「新たなインプットの結果、90%の確率でこうなる」というアウトプットを出すことになる。つまり、“Aという情報を投入すればBという結果が出る”というITによるシステムとは異なっており、100%完璧な解を導き出すことはできない。この百発百中とは限らない不確定性を内包したAIを、従来型のITとして捉えてしまうと現実的な実装は難しいと考えてしまうケースもあるため、実用性の視点ではその部分も理解したうえで業務に取り込んでいく必要がある。
また、内閣府の“人間中心のAI社会原則検討会議”が策定した「人間中心のAI社会原則」のなかにある「公平性、説明責任および透明性の原則」では、AIを利用する際に、人々が持つ背景によって不当な差別を受けたり、人間の尊厳に照らして不当な扱いを受けたりすることがないよう、公平性および透明性のある意思決定とその結果に対する説明責任(アカウンタビリティ)が適切に確保されることが求められている。実用性という視点では、ロジック自体を証明することは難しいものの、例えばAIがジェンダーで差別を行っていないといった事実を、何らかの形で証明できるようなものを実装していく必要があるだろう。なお、誰もが安心して利用できる、AI自体も多様性の価値を認識できる “インクルージブ(包括的な)AI”といったキーワードも登場しつつあるほどだ。
“現場のExcelが正しい情報”から脱却する「データガバナンス」
AIを用いて自社に適したモデルを作っていくためには、何よりも学習するためのインプットデータが不可欠だ。この学習データは精度の高いものが求められるが、これは人間よりもDeep Learningなどを含めたAIの方がある意味“真面目”だからこそ。人間であればノイズと感じる情報を自らフィルターできるが、AIはたとえ情報が誤っていたとしても素直に聞き入れてしまう。つまり、企業内にあるデータが最新のもので、改ざんされていない正しい情報かどうかが問われることになる。そのためには、データそのものを統制するデータガンバナンスの基盤がきちんと整備されている必要がある。
特に日本の現場では、中央集権的なDBで全ての情報が管理されているというよりは、担当者のPC内にあるExcelが最新の情報として業務で利用されていることも少なくない。この情報が部署や拠点ごとにばらばらに管理されており、ガバナンス自体が機能していないことが多いように見受けられる。これは、仕事の進め方としての違いも影響している。海外ではSOW(Statement Of Work:作業範囲記述書)にて明確に業務内容が規定されおり、不必要な情報にアクセスできないよう情報そのものが集中管理されているケースが多いが、日本は周辺も含めた業務全体を個人が請け負うことが多く、結果として情報そのものが属人化しやすい傾向にある。
まずはデータの棚卸しから始めていき、各データにアクセスすべき人たちの定義、更新ルールなどルールを決めて、さらにそれを専用のツールでカバーできるようにまでもっていくことが重要になってくるだろう。
Copyright © ITmedia, Inc. All Rights Reserved.


すご腕アナリスト市場予測
この記事の著者

こんなメディアも見られています
キーマンズネットに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
「パスキーはワナだ、使うな」にネット騒然 プロが“待った”をかけるワケ:902nd Lap
-
2
「Gemini Notebook」で始める「AI×自動化」実践ガイド
-
3
今、IT資格を取るならどれ? ランキングに見る「急浮上の資格」と「不動の資格」
-
4
48年も愛された名作CPU「Z80」を、引退に追い込んだ“抗えない事情”
-
5
止まらない不正アクセス、広がる情報漏えい 大手企業・公的機関を襲った10事案
-
6
「言い訳文化」から脱却のNECが足立区に伝授した生成AI活用術とは データ活用“逆算”の鉄則
-
7
大田区、年1000時間の問い合わせを「AI電話」で削減できるか? 実証実験で見えた課題
-
8
Microsoftの“あのキャラ”がまさかの復活? 公式「X」乗っ取り事件の珍騒動:901st Lap
-
9
同業の被害で初めて気付く漏えい 「アラート不発」を起こす攻撃の正体
-
10
相次ぐ不正アクセス、でもセキュリティ訓練は「やりっぱなし」の悲惨な実態【企業調査】
キーマンズネット SNS
 @Keymansをフォロー
インフォメーション
注目情報をチェック
キーマンズネットをフォロー