




















20年物の基幹システム刷新に、マクロミルがあえて「全てを変えない」と決めた理由
「1年では無理」――。20年間業務を支えてきた基幹システムの刷新は、そんな空気の中で始まった。マクロミルは期限内に移行を終え、夜間の停止を伴うリリースからも脱した。決め手は「全てをモダナイズしない勇気」だった。
長年使ってきた基幹システムを刷新したい。だが、長年の業務を支え、多くのシステムと連携しているものとなれば影響を見極めるだけでも一苦労だ。新しい技術を取り入れたい一方で、限られた期間にどこまで手を入れるべきか判断に迷うこともある。
オンラインリサーチを主力事業とするマクロミルは、20年にわたって業務を支えてきた基幹システムの移行を決断した。移行のきっかけとなった課題は、リリースに伴う手作業の負担やアクセス数、運用コストの増加だ。
移行に使える期間は約1年。「1年では無理」という空気の中で始まったプロジェクトは、運用コストの半減や無停止リリースの実現などの成果につながった。成功の鍵となった「基幹システム刷新の考え方」とはどのようなものだろうか。
不具合を直しても、すぐにリリースできない
マクロミルは、アンケートの配信から回答収集、集計、納品までのリサーチのプロセスをオンラインで提供している。国内モニター数は3600万人、年間取引社数は4000社超、年間プロジェクト件数は3万件以上に上る。
その業務を支えてきた基幹システムは、仮想マシン(VM)をベースに構築されていた。Webサーバは40以上のシステムと連携して毎秒1500件規模のトランザクションを処理し、バッチサーバでは約100のバッチ処理が動いていた。データはネットワークストレージと、VM上に構築した商用データベースに保存していた。
長年安定稼働を続けてきた一方で、課題は大きく分けて3つあった。(1)手作業の限界、(2)アクセス数の増加に合わせた処理能力の拡張、そして(3)コストだ。
Webサーバはセッション情報を自身のメモリに保持するステートフルな構成で、サーバ台数も固定されていた。台数を増やすにも手作業が必要で、柔軟な拡張が難しかった。デプロイやテストも手動で実施しており、リリースにはサービス停止と夜間の作業体制が必要だった。
同社でTech PMを務める片切亮氏は「手作業によってリリース時間やリリースサイクルの長期化につながっていました。バグが出てもすぐにリリースできない状況でした」と振り返る。有償ライセンスを含む運用コストも年々増加していた。
こうした課題を解消するため、2025年7月に基幹システムの基盤を刷新する集中プロジェクトを開始した。期間は1年間。「Google Cloud」への移行とシステムのモダナイズを進め、運用コストの削減と無停止リリースの実現を目指した。
当初は「1年では無理」という重苦しい空気があり、メンバーの意識もそろっていなかった。そんな中、課題やボトルネックを整理し、たたき台を作成して議論を重ねた。「Docker」を使ったコンテナ化のデモを通じて、少しずつ「やれる」という意識に変わっていった。
「新機能は加えない」 2日間で移行の方針を固める
3つの課題に対して、マクロミルはそれぞれ移行戦略を定めた。
処理能力拡張のために、コンテナの管理基盤である「Google Kubernetes Engine」(GKE)と「Memorystore for Valkey」を利用することにした。セッション情報をWebサーバのメモリからMemorystore for Valkeyに移し、個々のWebサーバが情報を保持しないステートレスな構成にすることで、自動的に処理能力を増減できる環境を目指した。
手動作業削減のために「GitHub Actions」を使ったCI/CDの仕組みを採用した。ビルドやデプロイを自動化して、迅速なリリースと無停止リリースにつなげた。
コスト削減のために商用データベースから「AlloyDB」への移行を進め、有償ライセンスの費用を解消する方針を立てた。
プロジェクトのゴールは2つあった。一つはデプロイの自動化とオートスケールによって、迅速なリリースや無停止リリースができる環境を構築すること。もう一つは利用者や連携するプロダクトへの影響を抑え、利用者が移行を意識せずに使い続けられるようにすることだ。
移行後の全体設計を固める上で役立ったのが、Google Cloudのエンジニアが企業のシステム設計やアプリケーションの試作を支援するワークショップ「Tech Acceleration Program」(TAP)だった。アプリケーションとSRE(Site Reliability Engineering)のチームが、2日間の議論を通じて移行先の構成と方針を共有した。
「TAPを通して、全てのリソースとデータをGoogle Cloudに移行することを決めました。マイグレーションにフォーカスして、アプリケーションの追加機能改修やロジック変更は行わない方針も決めました」(片切氏)
ここで言う「追加機能改修やロジック変更はしない」は、移行に必要な改修まで避けるという意味ではない。セッション情報の保持先の変更や、AlloyDBへの移行に必要なデータベース接続処理の改修は実施した。新機能の追加や業務ロジックの変更は移行と同時に進めず、取り組む範囲を絞った。
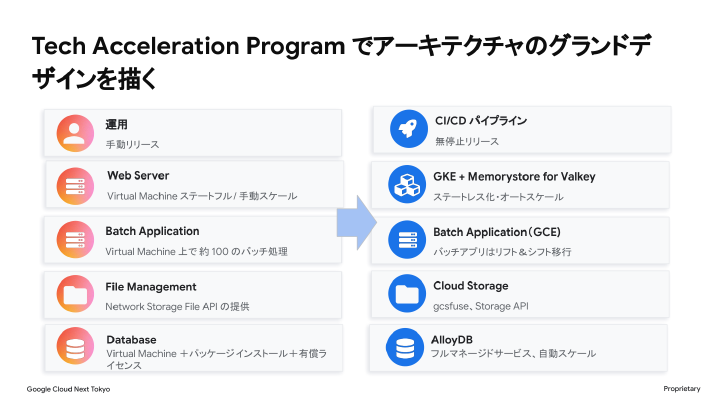 図1 移行前後の構成。Webはコンテナ化してバッチはVMのまま移行した(出典:マクロミルの講演資料)
連携先は40以上……業務への影響は?
プロジェクトには20人以上が参加し、3つのスクラムチームで2週間ごとのスプリントを進めた。運営においては「透明性」「建設的な議論」「リスペクト」の3つを重視した。中でも片切氏が「成功要因の一つ」として挙げたのが透明性だ。
基幹システムは40以上のシステムと連携しており、軽微な変更でも他のシステムに影響する可能性があった。そこで、スプリントレビューを公開して関連システムの担当者が自由に参加できるようにした。毎回50人以上が参加し、レビューを通じて改善を重ねたという。
2025年12月には開発と単体テストが完了し、2026年1月にはGoogle Cloudのテスト環境の構築を終えた。2026年6月に結合・性能・障害テストを完了して7月にリリースした。
刷新後は、ピーク時には6時間かかっていたVMの手動増設作業が不要になった。CPUやメモリの利用率に応じて、HPA(Horizontal Pod Autoscaler)がコンテナの実行単位であるPodを自動的に増減する構成に変わったためだ。
CI/CDによる自動デプロイによって、リリースに伴う夜間の6時間のサービス停止もなくなった。片切氏によると、軽微なアプリケーション層の変更であれば、サービスを止めずにリリースできるようになったという。
有償ライセンス費用の解消と手動のサーバメンテナンス工数の削減によって、運用コストは50%以上減った。
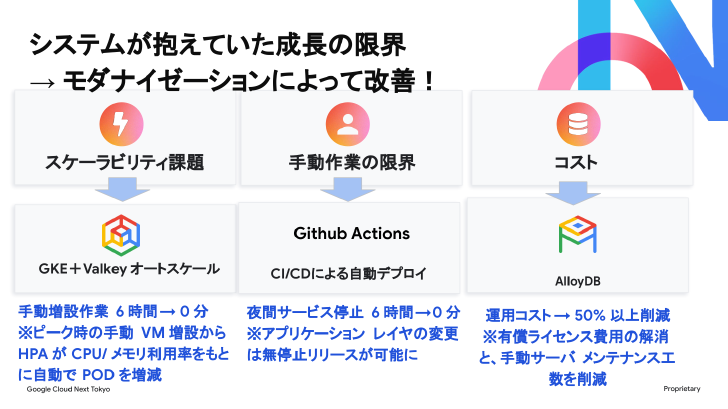 図2 基盤刷新による改善結果。無停止リリースの対象はアプリケーション層の変更(出典:マクロミルの講演資料)
Webはコンテナ化、バッチはVMのまま 自動化は両方に適用
移行後の構成と技術的なポイントは、同社でTech Leadを務めるアラン・ジョン(Allan Jone)氏が説明した。
WebアプリケーションはGKEのクラスタ内で稼働する。サービス間の通信を管理する「Istio」のサービスメッシュを構成し、プロダクトごとに名前空間を設けて区分するマルチテナント構成を採用した。モニタリングやログ転送、セキュリティ用のエージェントもクラスタ内に統合し、基幹システム以外の一部サービスも同じクラスタで動かしている。
データの保存先にはAlloyDB、クラウドストレージ「Cloud Storage」、Memorystore for Valkeyを利用し、IAM(Identity and Access Management)による認証・アクセス制御やプライベート接続を組み合わせた。Cloud Storageは「gcsfuse」を使って、バケットにファイルシステムとしてアクセスできるようにした。データ分析には「BigQuery」を採用した。
一方、バッチ処理は無理にコンテナ化せず、VMのまま「Compute Engine」に移した。既存の構成を大きく変えずに移行する「リフト&シフト」を選び、期限内の移行を優先した。
インフラは、構成をコードで管理するIaC(Infrastructure as Code)と、複数のプロダクトの構成を単一のリポジトリにまとめるモノレポで管理する。「Terraform」でCloud Storage、Memorystore for Valkey、VMの構成を標準化して「Atlantis」を使ってプルリクエストを基にGoogle Cloudのリソースを作成・変更する。組織、IAM、課金予算、タグも一元管理している。
CI/CDは「GitHub Actions」と「Argo CD」を利用して、Webアプリケーションとバッチ処理でデプロイ先に応じた仕組みを使い分けた。Webアプリケーションはコンテナイメージを「Artifact Registry」に登録してArgo CDでデプロイする。バッチ処理はGitHub Actionsと「Ansible」を使ってCompute EngineのVMに自動でビルド・デプロイする。
Webアプリケーションには新旧の実行環境を用意して切り替えるブルーグリーンリリースを採用した。バッチ処理の実行基盤はVMのままでも、ビルドやデプロイまで手作業で残すわけではない。移行方法と運用の自動化を分けて考えた。
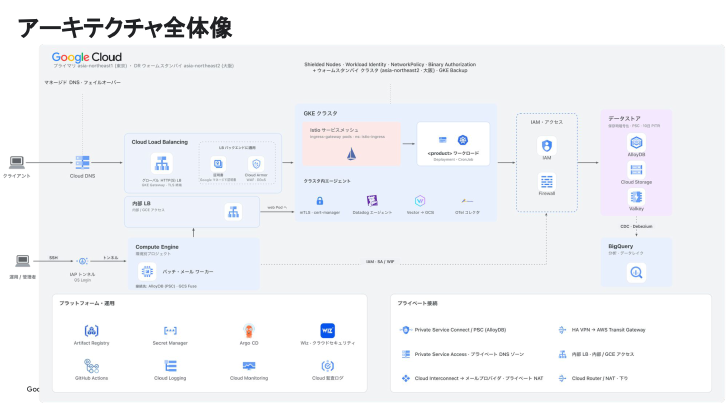 図3 移行後のアーキテクチャ全体像(出典:マクロミルの講演資料)
「全てをモダナイズしない」判断が、期限内の移行につながった
既存の仕組みを生かしたのはバッチ処理だけではない。GKE上のアプリケーションも、CSIドライバを使ってCloud StorageのバケットをPodにマウントし、旧基盤のパス構成を踏襲してファイル連携を維持した。既存クラウドで稼働するサービスは、VPN経由でAlloyDBに接続するハイブリッド構成とした。
アラン氏によれば、全てをモダナイズしない勇気を持ち、期日内の移行を最優先させたことがポイントだという。
片切氏は成功のポイントとして「適材適所」「自動化」「リスペクト」の3つを挙げた。Webはモダナイズしてバッチはリフト&シフトする使い分けが、短期間での移行につながった。Gitを基に構成やデプロイを管理するGitOpsによって再現性と安全性を高め、繰り返し発生する手動の運用作業を減らした点も大きかったという。既存システムと新しい技術の双方に敬意を払い、担当者同士が歩み寄ることも重視した。
リリース後には小さなトラブルもあったが、無停止リリースで対処できた。「今までの構成だったらできなかったことです」と片切氏は笑顔で語った。
本稿は「Google Cloud Next Tokyo 2026」のセッション「大規模レガシーを刷新! 手動運用からの脱却とCI/CDによるモダナイズ」を基に構成した。登壇者はマクロミルの片切亮氏とアラン・ジョン氏。
Copyright © ITmedia, Inc. All Rights Reserved.


事例で学ぶ! 業務改善のヒント
この記事の著者

関連記事
こんなメディアも見られています
キーマンズネットに関連する情報をお探しであれば、こちらのメディアもお役に立てるかもしれません。




SpecialPR
アクセスランキング
-
1
6TBファイルのサーバ移行、M365ユーザーの八雲町がSharePointでなく「あえてBox」の理由
-
2
今日から始める「AIエージェント」入門 ~Gemini Enterprise編~
-
3
「Claude」3倍高速化の裏で、Anthropic開発者が「あえてしなかったこと」:899th Lap
-
4
AIエージェントでサイバー攻撃は100倍速に 2026年最新事例から見る防御策とは
-
5
Javaアプレットは、なぜ今も情シスを悩ませる? 残った業務システムの“延命”問題
-
6
「閉じた環境」で生成AIをどう使うか 大分市が「庁内だけで使える環境」を構築
-
7
人同士の面接をAIが解析する「面接支援AI」提供開始 面接官のスキルアップも可能
-
8
「Gemini Notebook」になって何が変わった? NotebookLMからの変更点をおさらい
-
9
CodexやClaude Codeが作ったアプリ、実は「未完成」かも 本当に「完成」させる“5つの条件”
-
10
Excelの10万行データを3分でAIに処理させる、M365 Copilotの使い方
キーマンズネット SNS
 @Keymansをフォロー
インフォメーション
注目情報をチェック
キーマンズネットをフォロー